Medical Time Series: From Patient Data to Clinical Forecasting
Đây là bài ghi chú được mình rút trích từ seminar Medical Data Science on Time-series Data của AI VIETNAM. Nội dung đi từ cách hiểu dữ liệu y tế theo thời gian đến hai ví dụ thực hành: death forecasting trong Covid-19 và diabetes classification.
📎 Mở toàn bộ slide seminar (PDF)
Medical time series là gì?
Time series là dữ liệu được sắp xếp theo thứ tự thời gian. Trong y tế, mỗi điểm dữ liệu có thể là một lần đo nhịp tim, nồng độ glucose, huyết áp, kết quả xét nghiệm hoặc trạng thái của bệnh nhân.
Khác với một bảng dữ liệu thông thường, thứ tự và khoảng cách giữa các quan sát có thể mang ý nghĩa. Một giá trị riêng lẻ đôi khi không đủ để kết luận, nhưng xu hướng tăng, giảm hoặc thay đổi đột ngột theo thời gian lại có thể cung cấp tín hiệu quan trọng.
Slide 4-5 giới thiệu định nghĩa và một số ứng dụng của medical time series:
- theo dõi diễn tiến bệnh mãn tính;
- dự báo các sự kiện sức khỏe có thể xảy ra;
- hỗ trợ xây dựng phác đồ điều trị cá nhân hóa.
Ở đây, AI không chỉ nhìn vào câu hỏi “bệnh nhân có bệnh hay không”. Một mục tiêu quan trọng hơn là hiểu bệnh đang tiến triển thế nào và bước tiếp theo có thể xảy ra khi nào.
Vì sao dữ liệu y tế theo thời gian khó?
Dữ liệu phức tạp và biến thiên
Mỗi bệnh nhân có nền tảng sinh lý, bệnh sử và điều kiện theo dõi khác nhau. Dữ liệu đến từ các bệnh viện, thiết bị và quy trình khác nhau cũng có thể có format hoặc chất lượng không đồng nhất.
Slide 6 nhấn mạnh hai vấn đề lớn: heterogeneity và scale. Dữ liệu càng được thu thập liên tục, volume càng lớn, nhưng số lượng không đồng nghĩa với chất lượng. Model vẫn cần biết đâu là tín hiệu hữu ích và đâu là variation bình thường giữa các bệnh nhân.
Privacy và regulatory compliance
Dữ liệu y tế rất nhạy cảm. Slide 7-8 đề cập đến data security, GDPR, quyền được xóa dữ liệu và các yêu cầu pháp lý liên quan đến AI trong healthcare.
Nếu một model được dùng trong chẩn đoán hoặc chăm sóc quan trọng, yêu cầu không chỉ là accuracy cao. Hệ thống còn cần validation, reliability, safety và khả năng giải thích để bác sĩ hiểu cơ sở của kết quả.
Interpretation và clinical workflow
Một dự đoán sai trong medical AI có thể dẫn tới quyết định điều trị không phù hợp. Vì vậy, kết quả cần được diễn giải cẩn thận và tích hợp vào workflow của bệnh viện mà không làm gián đoạn quy trình chăm sóc hiện tại.
Điều này khiến bài toán triển khai khác xa một bài toán classification trên benchmark. Model cần phù hợp với người dùng cuối, với quy trình thực tế và với trách nhiệm lâm sàng.
Machine learning nên đóng vai trò gì trong medicine?
Seminar đặt machine learning trong một bối cảnh rộng hơn của biomedical science. ML có thể hỗ trợ precision medicine, giúp hiểu diễn tiến bệnh, hỗ trợ healthcare professionals và cải thiện việc phân bổ nguồn lực.
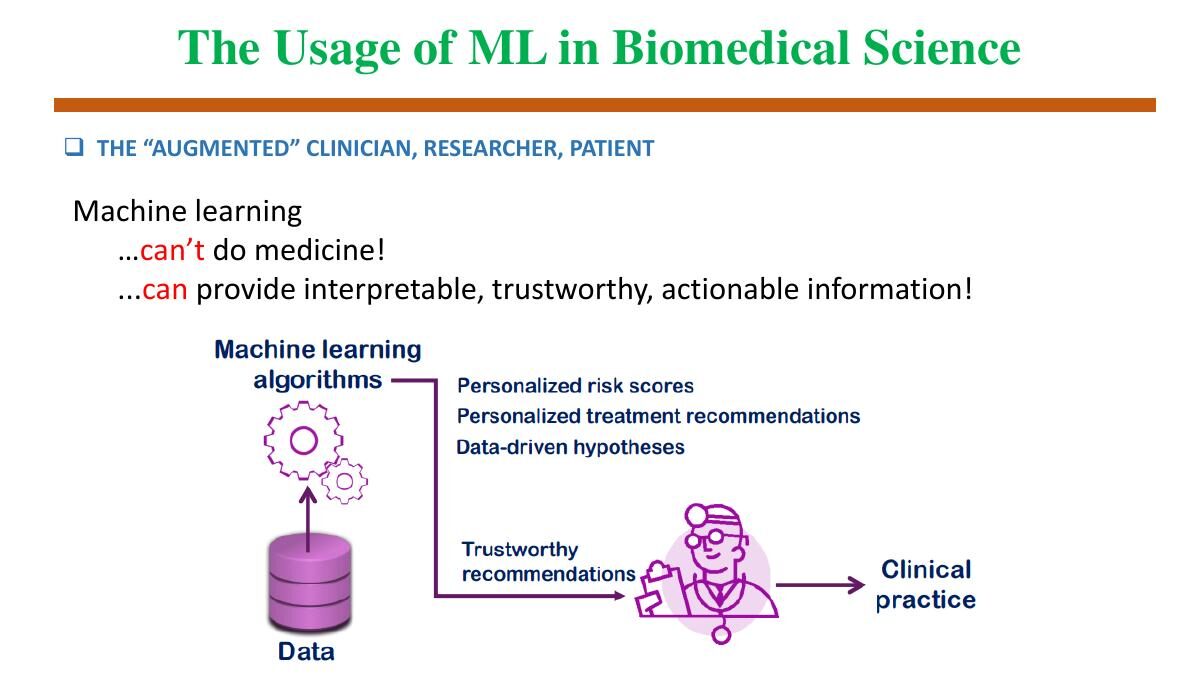
Nhưng một thông điệp rất đáng chú ý ở slide 13 là: machine learning không thể tự làm medicine. Vai trò phù hợp hơn là cung cấp thông tin có thể giải thích, đáng tin cậy và có khả năng hành động cho bác sĩ, nhà nghiên cứu hoặc bệnh nhân.
Nói cách khác, mục tiêu không nhất thiết là thay thế clinician bằng một model. Mục tiêu có thể là xây dựng một augmented clinician, nơi model giúp con người nhìn thấy pattern, nguy cơ hoặc xu hướng mà họ khó theo dõi thủ công trên lượng dữ liệu lớn.
Nhìn bệnh nhân như một quá trình thay đổi
Slide 15-17 mô tả healthcare time series như một bài toán nhiều mặt. Model có thể cần làm việc ở nhiều mức:
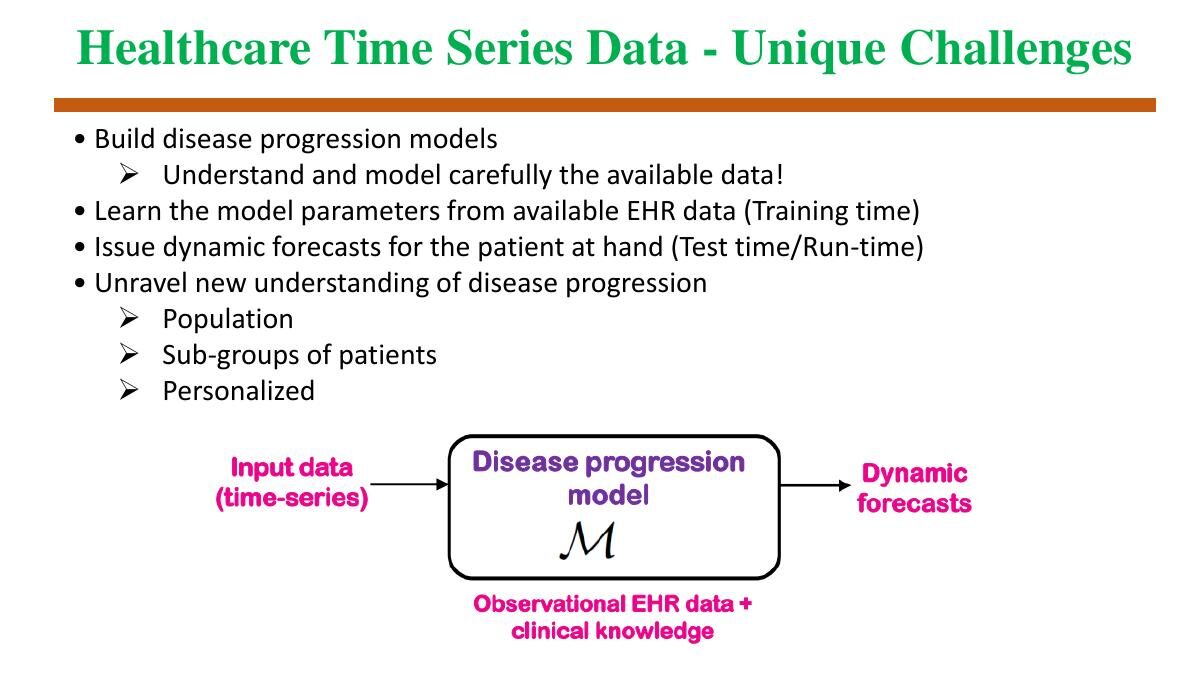
- mức population để hiểu xu hướng chung;
- mức subgroup để tìm các nhóm bệnh nhân có diễn tiến tương tự;
- mức personalized để đưa ra dự báo cho từng bệnh nhân.
Các câu hỏi quan trọng cũng thay đổi theo thời gian:
- Làm sao nhóm các bệnh nhân có diễn tiến tương đồng?
- Làm sao phát hiện bệnh sớm?
- Điều trị ảnh hưởng đến từng bệnh nhân theo thời gian như thế nào?
- Có thể dùng dữ liệu hiện tại để dự báo trạng thái tiếp theo không?
Một khó khăn khác là dữ liệu healthcare không dễ tiếp cận. Vì privacy, regulation và chi phí, ta có thể phải cân nhắc giữa dữ liệu đã de-identify và dữ liệu synthetic. Slide 22-24 lần lượt nhắc đến access, de-identified data và time-series generation.
Case study 1: dự báo tử vong trong Covid-19
Phần đầu tiên của thực hành dùng dữ liệu Covid-19 theo quốc gia và theo ngày. Dataset ban đầu có 35.156 records thuộc 187 country hoặc region, trong khoảng 22/01/2020 đến 27/07/2020.
Các trường dữ liệu chính gồm:
- ngày ghi nhận;
- quốc gia hoặc khu vực;
- WHO region;
- tổng số ca confirmed, deaths, recovered và active;
- số ca mới, số người tử vong mới và số người hồi phục mới.
Một quan hệ cơ bản trong slide là:
Confirmed = Deaths + Recovered + Active
Các giá trị mới được tính từ chênh lệch giữa hai mốc thời gian liên tiếp, chẳng hạn New cases = Confirmed(t) - Confirmed(t - 1).
Chuyển bảng dữ liệu thành bài toán dự báo
Trong bài toán time series, ta có thể dùng một cửa sổ gồm n records liên tiếp làm input và record thứ n + 1 làm output cần dự đoán. Slide 30 minh họa cách chuyển dữ liệu dạng bảng thành các sequence.
Sau đó, dữ liệu được chia thành train set và test set. Quy trình cơ bản gồm:
- khởi tạo model;
- fit model trên train set;
- predict test set;
- đánh giá bằng các metrics phù hợp.
Điểm cần nhớ là khi chia time series, không nên trộn ngẫu nhiên tương lai vào quá khứ. Nếu dữ liệu dùng để dự đoán tương lai đã lọt vào training, kết quả sẽ lạc quan hơn thực tế.
Case study 2: diabetes classification
Phần thứ hai dùng một dataset classification về tiểu đường. Các thuộc tính gồm số lần mang thai, glucose, huyết áp, độ dày da, insulin, BMI, Diabetes Pedigree Function và tuổi.
Nhãn Outcome cho biết kết quả cuối cùng, trong đó 0 là không mắc và 1 là mắc theo cách trình bày của slide. Dataset có 500 mẫu thuộc class 0 và 268 mẫu thuộc class 1, nên phân bố nhãn không hoàn toàn cân bằng.
Slide 41-44 tóm tắt pipeline quen thuộc:
- tách attributes thành
Xvà nhãnY; - chia train set và test set;
- khởi tạo model và fit trên train set;
- predict test set và đánh giá;
- visualization weights của các thuộc tính.
Việc xem trọng số feature giúp có thêm một góc nhìn về model, nhưng không nên hiểu một cách đơn giản rằng feature có weight lớn luôn là nguyên nhân của bệnh. Trong y tế, correlation, bias trong dataset và cách model được huấn luyện đều cần được xem xét kỹ.
Từ một bài thực hành đến một hệ thống medical AI
Hai case study trong seminar có độ phức tạp khác nhau. Covid-19 death forecasting đặt trọng tâm vào thứ tự thời gian và dự báo giá trị tiếp theo. Diabetes classification là bài toán phân loại trên các đặc trưng của bệnh nhân.
Tuy vậy, cả hai đều nhắc lại một nguyên tắc: pipeline model chỉ là một phần của bài toán. Trước đó còn có data collection, de-identification, preprocessing và thiết kế evaluation. Sau đó còn có interpretability, clinical validation và cách đưa kết quả vào quy trình chăm sóc.
Medical time series vì thế không chỉ là việc chọn một kiến trúc deep learning. Câu hỏi quan trọng hơn là dữ liệu đang mô tả quá trình nào, dự báo được dùng để hỗ trợ quyết định gì và làm sao để kết quả an toàn cho người thật.