Getting Started with AI Research: Choosing a Direction, Understanding Academia, and Finding Ideas
Đây là bài ghi chú được mình rút trích và sắp xếp lại từ Seminar 1 - AI Research Study & Career Path: How to get started trong khóa AI VIETNAM All-in-One Course. Một số nhận xét trong bài là cách mình diễn giải lại nội dung slide, nên không nên xem như “công thức chung” cho mọi người.
📎 Mở toàn bộ slide seminar (PDF)
AI Researcher và AI Engineer khác nhau ở đâu?
Thoạt nhìn, hai vai trò này có thể khá giống nhau: đều cần nền tảng machine learning, biết lập trình, đọc tài liệu kỹ thuật và làm việc với mô hình. Nhưng câu hỏi mà mỗi bên theo đuổi thường khác nhau.
AI Engineer thường quan tâm đến việc đưa một hệ thống vào hoạt động: mô hình có đủ nhanh không, chi phí inference bao nhiêu, sản phẩm có ổn định không, người dùng có sử dụng được không. Nói ngắn gọn, trọng tâm là tối ưu hóa, dữ liệu, sản phẩm và chi phí.
AI Researcher lại tập trung nhiều hơn vào việc tạo ra hoặc kiểm chứng tri thức mới: một giả thuyết có đúng không, phương pháp nào tốt hơn và vì sao, mô hình đang học điều gì, kết quả có tổng quát không. Trọng tâm nghiêng về benchmarking, mô hình, sự thật và tri thức. Slide 5-6 trình bày sự khác biệt này khá trực quan: hai hướng có thể giao nhau về skillset, nhưng mindset không hoàn toàn giống nhau.
Điều này không có nghĩa một người phải chọn một bên và bỏ hẳn bên còn lại. Trong thực tế, một researcher tốt vẫn cần biết code và đánh giá hệ thống, còn một engineer tốt cũng cần tư duy thực nghiệm và hiểu giới hạn của mô hình. Điểm khác nhau chủ yếu nằm ở câu hỏi mình muốn dành nhiều thời gian nhất để trả lời.
Academia vận hành như thế nào?
Một cách hình dung đơn giản trong slide 9 là:
University ↔ Professor / PI ↔ Funding
       ↕          ↕             ↕
   Master       PhD          Company
Trường đại học cung cấp môi trường và chương trình đào tạo. Professor hoặc PI (Principal Investigator) dẫn dắt nhóm nghiên cứu, định hình hướng đi và tìm nguồn funding. Funding giúp duy trì nghiên cứu, hỗ trợ nhân sự, dữ liệu, thiết bị và các hoạt động liên quan.
Vì vậy, học tiếp không chỉ là “học thêm một tấm bằng”. Đặc biệt ở bậc PhD, mình bước vào một hệ sinh thái nghiên cứu: làm việc với advisor, tham gia nhóm, đọc paper, thiết kế thí nghiệm, viết bài và dần hình thành một hướng chuyên môn của riêng mình.
Các lộ trình học tiếp thường gặp
Slide 8-15 đưa ra một số lộ trình phổ biến, không phải quy định cứng:
- Master rồi đi industry: thường kéo dài khoảng 1-2 năm ở nhiều khu vực. Sau đó có thể chuyển sang AI Engineer hoặc các vai trò liên quan.
- Master rồi học PhD: có thể đi từ châu Á sang châu Á/châu Âu, hoặc từ châu Á sang các nước như Mỹ, Australia hay một số chương trình khác. Tổng thời gian thường dài hơn nhưng phù hợp với người muốn theo academia hoặc research scientist.
- Direct PhD: một số trường và quốc gia cho phép đi thẳng từ bậc undergraduate lên PhD. Lộ trình này ngắn hơn về tổng số bằng phải học, nhưng yêu cầu đầu vào thường cao hơn về tiếng Anh, research experience và thành tích nghiên cứu.
Các con số về thời lượng, IELTS hay scholarship trong slide nên được xem là mốc tham khảo tại thời điểm seminar. Khi thật sự nộp hồ sơ, mình vẫn cần kiểm tra yêu cầu chính thức của từng trường và từng chương trình.
Một điểm mình thấy khá thực tế là bài toán không chỉ nằm ở “trường nào tốt hơn”. Mình còn phải cân nhắc income, freedom, thời gian, khả năng nhận scholarship và mức độ phù hợp với cuộc sống của bản thân. Chọn lộ trình học thuật cũng là chọn cách mình muốn sống trong vài năm tiếp theo.
Tìm hướng nghiên cứu: đừng bắt đầu bằng một từ khóa quá rộng
Slide 17-18 mô tả một knowledge pyramid. Có thể bắt đầu từ những tầng khác nhau:
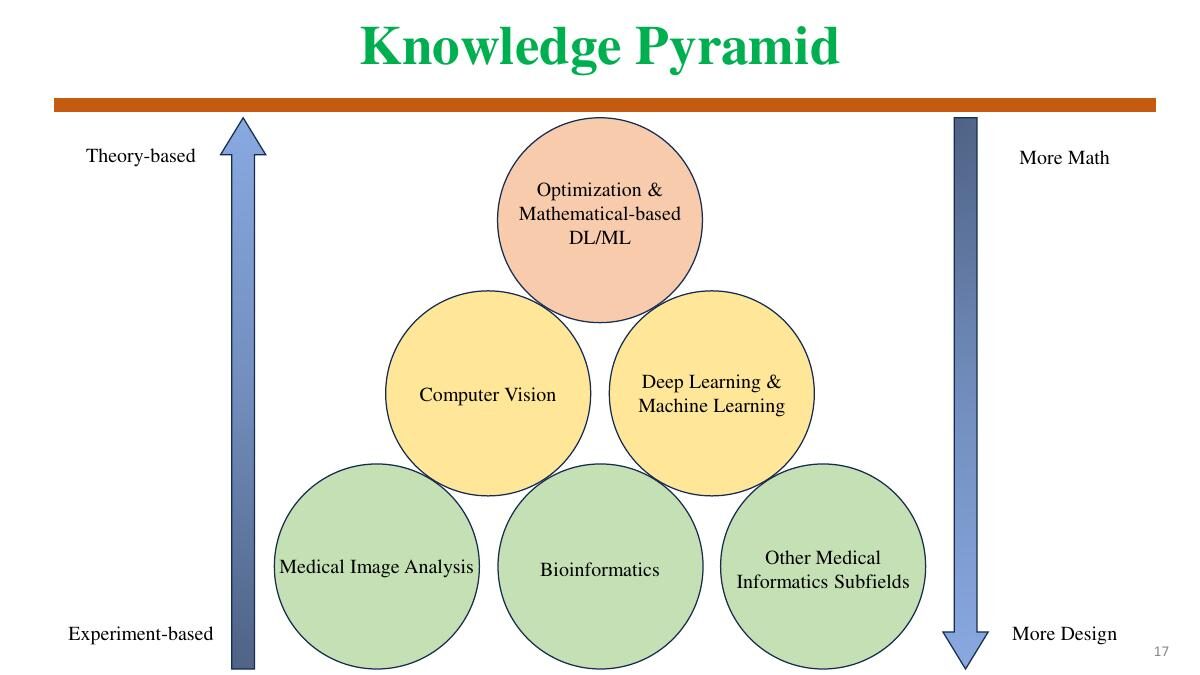
Mathematical / optimization-based AI
                ↓
      Deep Learning & Computer Vision
                ↓
       Medical Image Analysis
                ↓
        Một bài toán cụ thể
Ví dụ, “machine learning” là một vùng quá lớn. Đi xuống một tầng, mình có thể chọn computer vision. Đi tiếp, mình có thể quan tâm đến medical image analysis. Cuối cùng, một hướng cụ thể hơn có thể là semi-supervised medical segmentation.
Đi từ trên xuống giúp mình có nền tảng và ngữ cảnh. Đi từ dưới lên lại giúp mình bắt đầu với một bài toán gần thực tế hơn. Không có chiều nào luôn đúng; quan trọng là biết mình đang đứng ở đâu trong bản đồ kiến thức.
Phần ví dụ về semi-supervised learning ở slide 18-21 cũng cho thấy một hướng nghiên cứu có thể nối nhiều lớp với nhau:
- từ theory và concept của semi-supervised learning;
- sang semi-supervised image classification hoặc semantic segmentation;
- rồi đến semi-supervised medical segmentation.
Nhìn theo cách này, “chọn topic” không nhất thiết là nghĩ ra một cái tên thật mới ngay từ đầu. Trước hết, mình cần tìm một vùng giao nhau giữa nền tảng mình có, bài toán mình quan tâm và những vấn đề còn chưa được giải quyết tốt.
AI Research Pyramid và khoảng trống để đóng góp
Slide 22-23 chia research thành ba vùng:
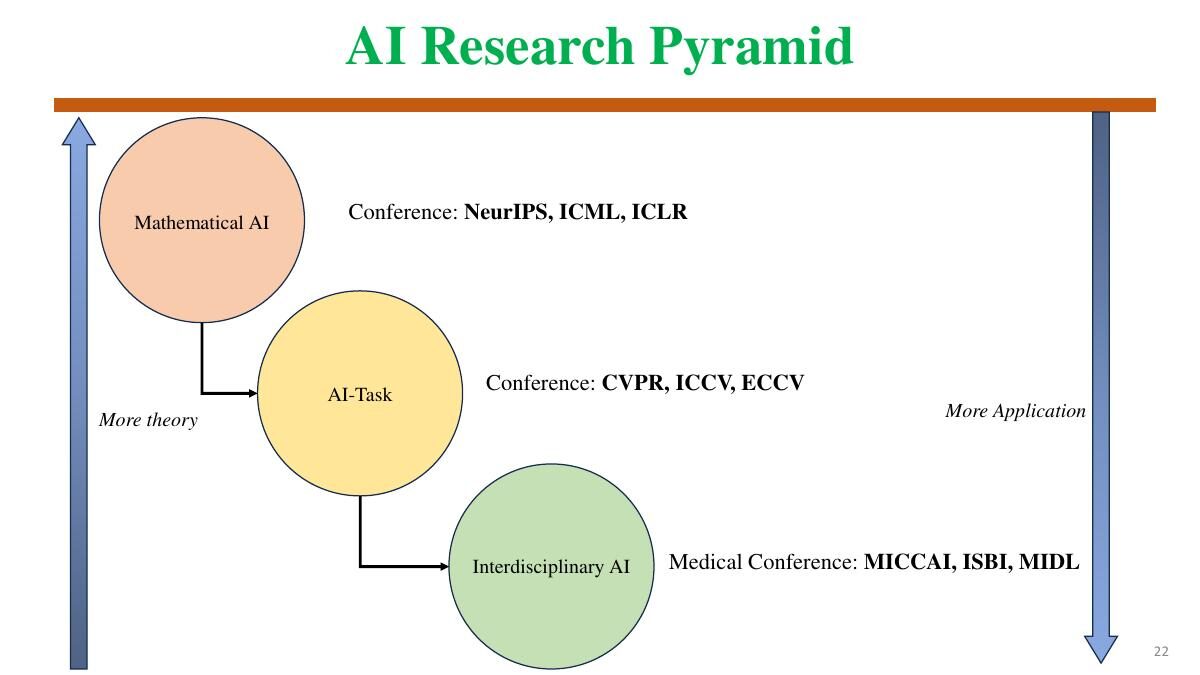
- Mathematical AI: nhiều về theory, optimization và mathematical modeling; các conference tiêu biểu được slide nhắc tới là NeurIPS, ICML và ICLR.
- AI Task: tập trung vào các bài toán như computer vision; ví dụ CVPR, ICCV và ECCV.
- Interdisciplinary AI: kết hợp AI với một lĩnh vực khác như y tế; ví dụ MICCAI, ISBI và MIDL.
Một quan sát quan trọng là ý tưởng thường bị “lọc” khi đi qua các tầng. Có rất nhiều paper ở Mathematical AI, nhưng chỉ một phần nhỏ được chuyển thành module hữu ích cho một AI task cụ thể. Tương tự, không phải kỹ thuật tốt nào trong computer vision cũng giải quyết được một vấn đề thực tế trong medical image analysis.
Khoảng trống có thể nằm chính ở các điểm nối đó.
Một vài cách tìm ý tưởng mới
1. Đi từ downstream task
Nếu đang làm ở một lĩnh vực ứng dụng, mình có thể đọc literature của bài toán hiện tại trước, sau đó mở rộng sang lĩnh vực gần bên. Slide 24 gọi đây là hướng downstream:
- đọc các paper trong medical image analysis;
- đọc các paper computer vision liên quan;
- đặt giả thuyết và thiết kế lại một ý tưởng cũ cho bài toán của mình.
Ví dụ ở slide 25, các ý tưởng từ semi-supervised learning được theo dõi từ FlexMatch đến DC-Net rồi đặt trong bối cảnh downstream cụ thể.
2. Lấp khoảng trống trong cùng lĩnh vực
Không nhất thiết phải “nhảy ngành” mới có ý tưởng. Mình có thể đọc một topic chính, sau đó xem các topic gần đó đang giải quyết vấn đề gì. Slide 26 gọi đây là fill gaps (same field).
Ví dụ kinh điển ở slide 27 là cách Transformer trong NLP gợi mở cho Vision Transformer. Tất nhiên, đem một ý tưởng sang lĩnh vực khác không phải chỉ đổi tên dữ liệu; phần quan trọng là hiểu giả định nào của ý tưởng cũ còn đúng, giả định nào cần sửa.
3. Kết hợp cross-field
Với fill gaps (cross-field), mình chủ động tìm giao điểm giữa hai lĩnh vực. Slide 28 minh họa bằng việc nối NLP và computer vision.
Đây là hướng dễ tạo ra ý tưởng thú vị, nhưng cũng dễ rơi vào việc ghép hai từ khóa một cách cơ học. Một câu hỏi kiểm tra hữu ích là: vấn đề của lĩnh vực A có thật sự tương đồng với vấn đề của lĩnh vực B không, hay chỉ giống nhau ở tên gọi?
4. Thêm constraint
Một cách khác là giữ một bài toán quen thuộc nhưng thêm điều kiện khó hơn: dữ liệu noisy, domain shift, thiếu modality, giới hạn compute, hoặc yêu cầu robustness. Slide 29-31 minh họa hướng này qua việc kết hợp domain adaptation, object detection và noisy labeling trong bối cảnh mammogram.
Constraint không chỉ làm bài toán khó hơn. Nếu constraint phản ánh một vấn đề thực tế, nó có thể khiến một bài toán cũ trở nên có ý nghĩa hơn.
Có nên chạy theo trend?
Cuối seminar, slide 32 đặt ra hai câu hỏi mở: có nên chạy theo research trend không, và làm sao xác định một topic có tiềm năng?
Mình nghĩ câu trả lời hợp lý không phải là “có” hoặc “không” tuyệt đối. Trend giúp mình biết cộng đồng đang quan tâm điều gì, paper nào đang được đọc nhiều và kỹ thuật nào có khả năng tạo ra tác động. Nhưng nếu chỉ chạy theo từ khóa, mình rất dễ làm một project mà bản thân không hiểu sâu hoặc không có lợi thế riêng.
Một hướng cân bằng hơn là:
- dùng trend để tìm cửa vào;
- dùng nền tảng của mình để chọn bài toán phù hợp;
- đọc đủ sâu để tìm assumption, limitation hoặc khoảng trống;
- rồi kiểm chứng bằng một experiment nhỏ trước khi đầu tư lớn.
Research không bắt đầu từ việc biết chắc câu trả lời. Nó bắt đầu từ việc đặt một câu hỏi đủ rõ để mình có thể kiểm chứng.
Kết
Điều mình rút ra sau khi xem lại seminar là: bắt đầu research không nhất thiết phải bắt đầu bằng một ý tưởng “đột phá”. Có thể bắt đầu bằng việc phân biệt mình muốn tối ưu sản phẩm hay muốn hiểu một vấn đề; vẽ lại bản đồ kiến thức; đọc có chiến lược; và tập nhìn các khoảng trống giữa những lĩnh vực gần nhau.
Nếu đang ở những bước đầu, một quy trình nhỏ nhưng thực tế có thể là:
- chọn một bài toán cụ thể thay vì một keyword quá rộng;
- đọc một vài paper nền tảng và vài paper gần đây;
- ghi lại assumption, limitation và cách đánh giá của từng paper;
- thử một baseline đơn giản;
- chỉ mở rộng ý tưởng sau khi đã hiểu kết quả đầu tiên.
Không phải mọi project đều trở thành paper. Nhưng mỗi project được làm nghiêm túc đều có thể giúp mình hiểu rõ hơn về cách đặt câu hỏi, thiết kế thí nghiệm và chọn hướng đi tiếp theo.