FMMix: Feature-Space Augmentation for Better Model Generalization
Đây là bài ghi chú được mình rút trích từ seminar FMMix: A Novel Augmentation Strategy for Enhancing Feature Diversity to Boost Model Generalization for Image Data. Bài viết tập trung vào trực giác từ các hình feature map, cách FMMix chọn vùng để trộn và những gì các bảng kết quả cùng loss surface gợi ý.
📎 Mở toàn bộ slide seminar (PDF)
Bài toán bắt đầu từ generalization
Một model có thể đạt accuracy cao trên training data nhưng hoạt động kém trên dữ liệu chưa từng thấy. Slide đặt vấn đề này cạnh hai yếu tố quen thuộc: data quality and quantity, cùng algorithm và model architecture.
Slide 4-8 chỉ ra một số nguyên nhân khiến model overfit hoặc khó tổng quát:
- dữ liệu training không đủ;
- noisy data;
- thiếu regularization;
- object occlusion;
- model quá phức tạp so với lượng dữ liệu.
Vì vậy, augmentation không chỉ là một kỹ thuật phụ để làm dataset lớn hơn. Nó là một cách thay đổi distribution của dữ liệu training để model học được representation bền vững hơn.
Từ input-level augmentation đến feature-level augmentation
Mixup trộn hai ảnh và hai nhãn theo một hệ số. CutMix thay thế một vùng của ảnh bằng vùng từ ảnh khác rồi điều chỉnh nhãn theo tỷ lệ diện tích. Các phương pháp này làm việc ở input space.
FMMix đặt một câu hỏi khác: nếu thay vì trộn pixel, ta trộn feature map ở bên trong mạng thì sao? Slide 10-12 đặt câu hỏi về layer-specific augmentation và combination augmentation.
Trực giác từ hình “Channels” ở slide 18 khá quan trọng. Khi ảnh đi qua CNN, các channel ở những layer khác nhau không còn chỉ là màu RGB. Chúng dần biểu diễn cạnh, texture, shape và pattern có mức trừu tượng cao hơn.
Nếu augmentation ở input chỉ thay đổi ảnh đầu vào, feature-space augmentation có thể tác động trực tiếp vào representation mà classifier thực sự sử dụng. Đây là lý do feature map có thể tạo ra những biến thể giàu thông tin hơn mà không cần sinh một ảnh mới hoàn chỉnh.
FMMix định nghĩa lại việc trộn
Với Mixup truyền thống, ta trộn hai input theo một hệ số lambda:
x_tilde = lambda * x_a + (1 - lambda) * x_b
y_tilde = lambda * y_a + (1 - lambda) * y_b
FMMix thay việc trộn toàn bộ input bằng việc tạo một mask trên feature map ở một layer của CNN. Slide 17 đặt hai formulation cạnh nhau: input-level mixing ở bên trái và feature-level mixing ở bên phải.
Với feature map, các vùng lấy từ sample A và sample B được trộn theo mask. Nhãn không còn nên phụ thuộc một cách máy móc vào một hệ số lambda duy nhất. Nó cần phản ánh lượng semantic information mà mỗi vùng đóng góp.
Đây là insight cốt lõi của phương pháp: feature map không phải một ảnh pixel thông thường, nên tỷ lệ trộn cũng cần được định nghĩa lại theo representation và semantic information.
Region-focused augmentation
ResNet cho thấy feature thay đổi theo block
Slide 19 đặt feature map và feature vector vào kiến trúc ResNet18. Ở các block đầu, feature map còn có spatial resolution tương đối lớn và chứa pattern cục bộ. Ở những block sau, representation trừu tượng hơn và dần chuyển sang feature vector.
Điều này gợi ra một lựa chọn thiết kế: FMMix nên hoạt động ở layer nào, và nên trộn toàn bộ feature map hay chỉ những vùng có ý nghĩa?
Channel Max Position Detector
Trong region-focused augmentation, FMMix tìm vị trí có activation lớn trong từng channel. Slide 20 minh họa Channel Max Position Detector: với mỗi channel, lấy vị trí có activation cực đại rồi tạo vùng xung quanh vị trí đó.
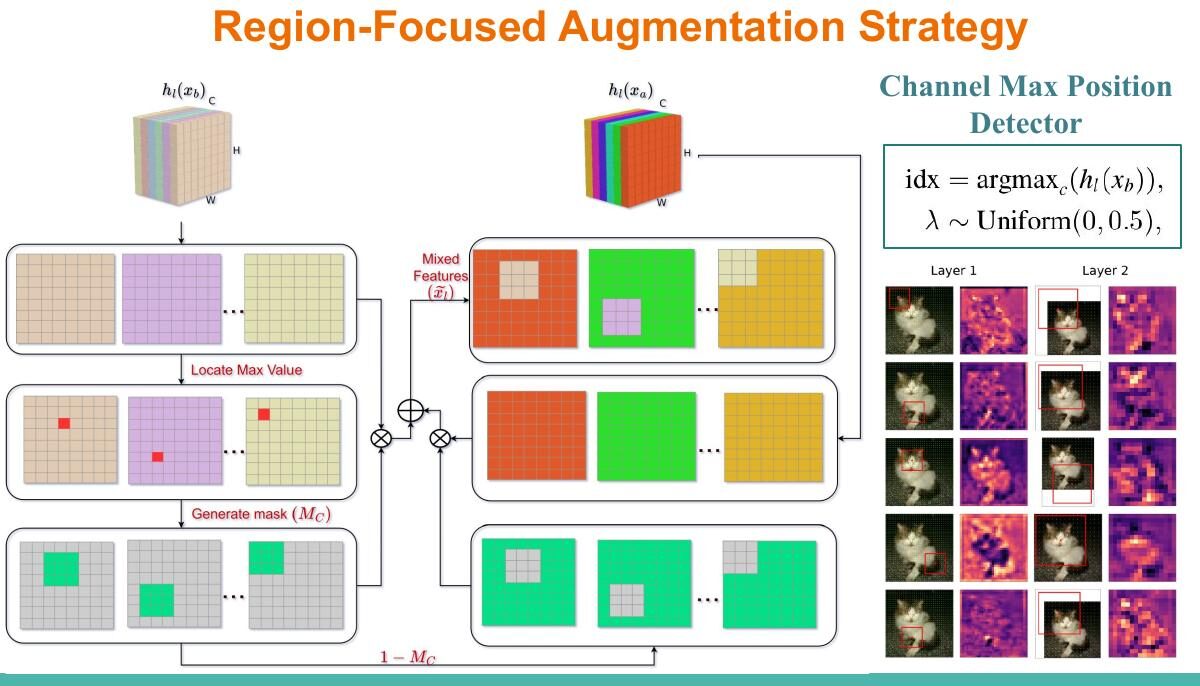
Hình bên phải cho thấy các vùng được đánh dấu trên ảnh và activation map. Cách làm này cố gắng tập trung augmentation vào nơi representation đang phản ứng mạnh, thay vì cắt một vùng hoàn toàn ngẫu nhiên.
Top-k channel patches
Ở slide 21, FMMix chia feature map thành các patch không overlap, tính một giá trị đại diện cho từng patch và chọn top-k patch. Các patch được chọn tạo thành mask để lấy vùng từ sample khác.
Từ hình pipeline, có thể đọc phương pháp thành ba bước:
- chia feature map thành những vùng nhỏ;
- đánh giá vùng nào chứa activation hoặc information quan trọng hơn;
- tạo mask từ các vùng được chọn rồi trộn feature giữa hai sample.
Đây là điểm khác với CutMix. CutMix chọn vùng hình chữ nhật trên ảnh. FMMix chọn vùng dựa trên feature response ở một layer cụ thể, nên mask có thể liên quan trực tiếp hơn đến cách model đang nhìn dữ liệu.
Label mixing calibration
Nếu ta trộn hai feature map, nhãn mới cần được tính lại. Slide 22 trình bày hai ý tưởng: area ratio và semantic information percentage.
Area ratio đo phần diện tích đóng góp của từng sample trong feature map trộn. Semantic information percentage bổ sung một góc nhìn khác: không phải mọi vùng có cùng diện tích đều chứa lượng thông tin như nhau.
Vì vậy, label mixing calibration cố gắng làm cho trọng số của nhãn phù hợp hơn với feature thực sự được đưa vào classifier. Nếu một sample chỉ chiếm diện tích nhỏ nhưng chứa vùng activation quan trọng, việc dùng diện tích đơn thuần có thể đánh giá thấp đóng góp của sample đó.
Các biến thể của FMMix
Slide 23 so sánh bốn biến thể theo việc có dùng max position, top-k patches, feature map area ratio và semantic information hay không.
Slide cũng phân biệt FMMix với những phương pháp trước đó theo nhiều trục:
- làm việc trên image hay feature map;
- trộn theo channel hay không;
- có region-focused strategy hay không;
- có regional dropout hay không.
Nhìn theo bảng này, FMMix không chỉ là “đổi input thành feature”. Phương pháp là sự kết hợp của feature-map mixing, chọn vùng theo activation và hiệu chỉnh label theo thông tin của vùng.
Experimental setup
Thí nghiệm dùng nhiều loại dataset để kiểm tra khả năng tổng quát ở các domain khác nhau: CIFAR-100, Tiny ImageNet, CUB-200-2011, Aircraft và ESC-50.
Slide 25 cho thấy setup thay đổi theo dataset về số class, kích thước input, pretrained model, batch size và model architecture. Các backbone gồm ResNet18, ResNet50, EfficientNetV2S, MobileNetV3Large và ResNet100.
Việc thử trên cả natural image, fine-grained classification và audio classification làm cho câu hỏi về generalization rộng hơn một benchmark duy nhất. Nó giúp kiểm tra xem feature-space augmentation có chỉ hợp với một kiểu dữ liệu hay có thể chuyển sang nhiều bối cảnh.
Kết quả: FMMix có thực sự giúp model tốt hơn không?
Slide 28 so sánh Baseline, Mixup, Manifold Mixup, CutMix và FMMix. Một số kết quả nổi bật:
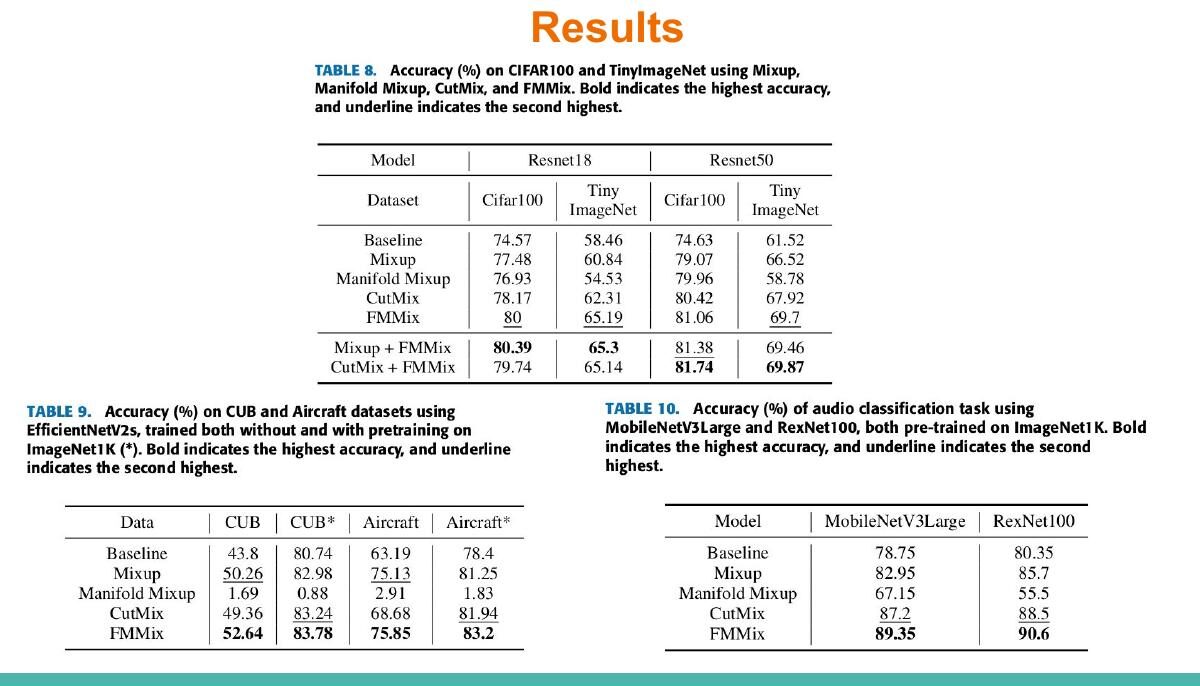
- Với ResNet18 trên CIFAR-100, FMMix đạt 80.00%, cao hơn Mixup 77.48% và CutMix 78.17%.
- Với ResNet18 trên Tiny ImageNet, FMMix đạt 65.19%, trong khi Mixup đạt 60.84% và CutMix 62.31%.
- Khi kết hợp Mixup với FMMix, CIFAR-100 đạt 80.39% trên ResNet18.
- Trên CUB và Aircraft, FMMix lần lượt đạt 52.64% và 75.85% trong bảng kết quả của slide.
- Với audio classification, FMMix đạt 89.35% trên MobileNetV3Large và 90.6% trên ResNet100.
Điểm đáng chú ý không phải chỉ là một con số cao nhất. FMMix được thử trong nhiều model và dataset, nên kết quả gợi ý rằng việc trộn feature có thể bổ sung cho input-level augmentation thay vì chỉ thay thế nó.
Nhìn loss surface để hiểu generalization
Các hình loss surface ở slide 29-30 so sánh Baseline, Mixup, CutMix, Manifold Mixup và FMMix.
Khi nhìn vào hình, Manifold Mixup xuất hiện với bề mặt có nhiều biến động mạnh và vùng lõm sâu. FMMix trong các ví dụ được trình bày có bề mặt mượt và ổn định hơn so với một số baseline. Đây không phải là bằng chứng duy nhất để kết luận model luôn tốt hơn, nhưng nó cung cấp một trực giác hình học: augmentation có thể thay đổi landscape mà optimizer phải đi qua.
Từ đó, insight hợp lý là generalization không chỉ liên quan đến accuracy trên test set. Cách loss thay đổi xung quanh nghiệm cũng có thể cho ta thêm thông tin về độ nhạy và độ ổn định của model.
Kết
FMMix bắt đầu từ một quan sát đơn giản: nếu input-level augmentation đã thay đổi dữ liệu, ta có thể thử tác động trực tiếp lên feature representation mà model đang học.
Phương pháp này làm ba việc cùng nhau:
- trộn feature map thay vì chỉ trộn ảnh;
- tập trung vào region có activation hoặc information đáng chú ý;
- hiệu chỉnh label theo diện tích và semantic information.
Hình ảnh trong slide giúp nối những ý tưởng này thành một pipeline: ResNet tạo feature map, detector chọn vùng, mask trộn feature, calibration điều chỉnh label, rồi bảng kết quả kiểm tra khả năng tổng quát trên nhiều dataset.