Domain Generalization: When Models Must Work in Unseen Domains
Đây là bài ghi chú được rút trích từ seminar Domain Generalization and introduction to DomainBed. Mình giữ lại các ví dụ và thuật ngữ chính trong slide, sau đó diễn giải lại theo cách dễ theo dõi hơn.
📎 Mở toàn bộ slide seminar (PDF)
Vì sao model có thể tốt trên test set nhưng lại “đuối” ngoài đời?
Một mô hình machine learning thường được đánh giá trên dữ liệu có cùng kiểu phân phối với dữ liệu train. Nhưng khi triển khai, dữ liệu có thể đến từ một bệnh viện khác, một camera khác, một quốc gia khác hoặc một điều kiện ánh sáng khác.
Khi đó, model không còn nhìn thấy đúng “thế giới” mà nó đã học.
Vấn đề này thường được gọi là domain shift. Domain có thể khác nhau vì nhiều lý do: thiết bị chụp, quy trình thu thập, nhân khẩu học, background, độ phân giải, cách tiền xử lý hoặc những pattern vô tình xuất hiện trong dataset.
Slide 4-5 mở đầu bằng một ví dụ về bias trong dữ liệu. Một hệ thống có thể hoạt động tốt trên nhóm dữ liệu này nhưng kém hơn rõ rệt trên nhóm khác, không hẳn vì thuật toán “ngu”, mà vì dataset đã dạy nó một cách nhìn không cân bằng.
Bias thường đến từ data
Slide 4 đặt câu hỏi “Is AI biased?” và dùng ví dụ về kết quả tìm kiếm cho từ khóa “CEO”. Slide 5-6 tiếp tục minh họa rằng dữ liệu và cách dữ liệu được phân bố có thể ảnh hưởng trực tiếp đến prediction.
Một ví dụ khác trong slide dẫn lại phân tích về facial recognition: hiệu năng có thể chênh lệch đáng kể giữa các nhóm màu da và giới tính. Khi dataset thiếu đại diện hoặc chứa spurious correlation, model có thể học một shortcut rất mạnh nhưng không bền vững.
Nói cách khác, model có thể không thật sự học “đặc điểm cần thiết” của bài toán. Nó có thể học background, góc chụp, phong cách camera hoặc một dấu hiệu phụ nào đó chỉ xuất hiện trong train set.
Slide 7-9 dùng một toy experiment để cho thấy model dễ bị ảnh hưởng bởi viewpoint, vật thể bị che khuất và các pattern khác thường. Những ví dụ này đơn giản, nhưng gợi ra một vấn đề lớn hơn: dataset có signature riêng và signature đó không nhất thiết tồn tại trong domain mới.
Bài toán của data signature
Slide 10 tóm tắt một số key points:
- nhiều paper không báo cáo cross-domain performance;
- mỗi dataset có một signature riêng, có thể nhận diện được;
- cần có giải pháp cho khoảng cách giữa các dataset.
Đây là điểm khá quan trọng. Nếu chỉ báo cáo kết quả trên một benchmark, ta mới biết model làm tốt trong benchmark đó. Ta chưa biết model có hiểu bản chất của task hay chỉ nhận ra các dấu hiệu đặc thù của dataset.
Domain Adaptation: biết trước target domain
Trong domain adaptation, ta train trên source domain rồi cố gắng thích nghi sang target domain. Slide 12 minh họa quy trình bằng source như GTA5 và target như Cityscapes.
Trong unsupervised domain adaptation, target data có thể không có nhãn, nhưng ta vẫn biết trước target domain và thường có thể tiếp cận một phần dữ liệu của nó trong quá trình training.
Một số hướng được slide nhắc đến gồm:
- adversarial domain adaptation;
- pixel-wise consistency;
- các phương pháp học representation ít phụ thuộc domain hơn.
Slide 13 đặt domain adaptation cạnh một số công trình như DANN, ADDA và PixMatch.
Nhưng có một hạn chế rất thực tế: nếu target data chưa xuất hiện trước deployment thì sao?
Slide 14 nhấn mạnh rằng ta thường không thể thu thập hoặc sử dụng target data trước vì privacy, regulation, chi phí hoặc yêu cầu real-time deployment.
Domain Generalization: không thấy target trước nhưng vẫn phải tổng quát
Domain generalization (DG) đặt ra một bài toán khó hơn: train model trên một hoặc nhiều source domains, sau đó deploy trên một domain hoàn toàn mới mà model chưa từng thấy.
Slide 15 mô tả ví dụ có Hospital A, B và C trong training, rồi triển khai sang Hospital D.
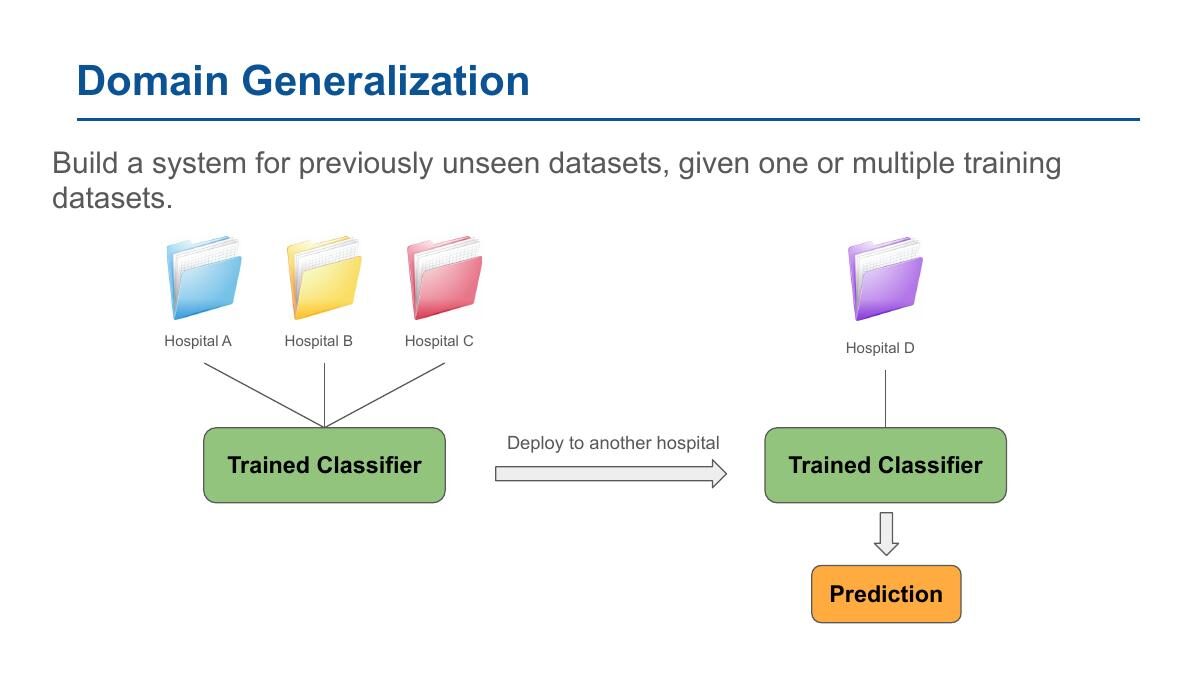
Ở đây, ta không thể dựa vào việc “nhìn trước” target data để điều chỉnh model. Model phải học được những feature ổn định hơn giữa các source domains, thay vì ghi nhớ signature riêng của từng domain.
Ví dụ trong medical imaging rất dễ hình dung: cùng một loại bệnh nhưng ảnh đến từ scanner, protocol hoặc bệnh viện khác nhau. Một model tốt không nên chỉ nhận ra style của một bệnh viện; nó cần giữ được tín hiệu liên quan trực tiếp đến bệnh lý.
Các hướng tiếp cận DG
Slide 16-17 nhắc đến nhiều hướng nghiên cứu khác nhau, trong đó có:
- ensemble và model selection;
- mutual-information regularization;
- sharpness-aware gradient matching;
- các chiến lược giúp representation ổn định hơn giữa các domain.
Những hướng này khác nhau về cơ chế, nhưng cùng nhắm tới một mục tiêu: giảm sự phụ thuộc vào đặc điểm riêng của source domain và tăng khả năng tổng quát sang domain mới.
Một điểm cần chú ý là DG không chỉ là “thêm một loss”. Kết quả còn phụ thuộc vào cách chia domain, cách chọn model, augmentation, protocol đánh giá và cả việc domain mới thực sự khác source đến đâu.
DomainBed là gì?
Nếu mỗi paper tự chọn dataset, algorithm, model selection và cách đánh giá khác nhau, việc so sánh giữa các phương pháp sẽ rất khó. Đây là lý do cần một benchmark và platform thống nhất.
Slide 18 giới thiệu DomainBed, một framework tập hợp:
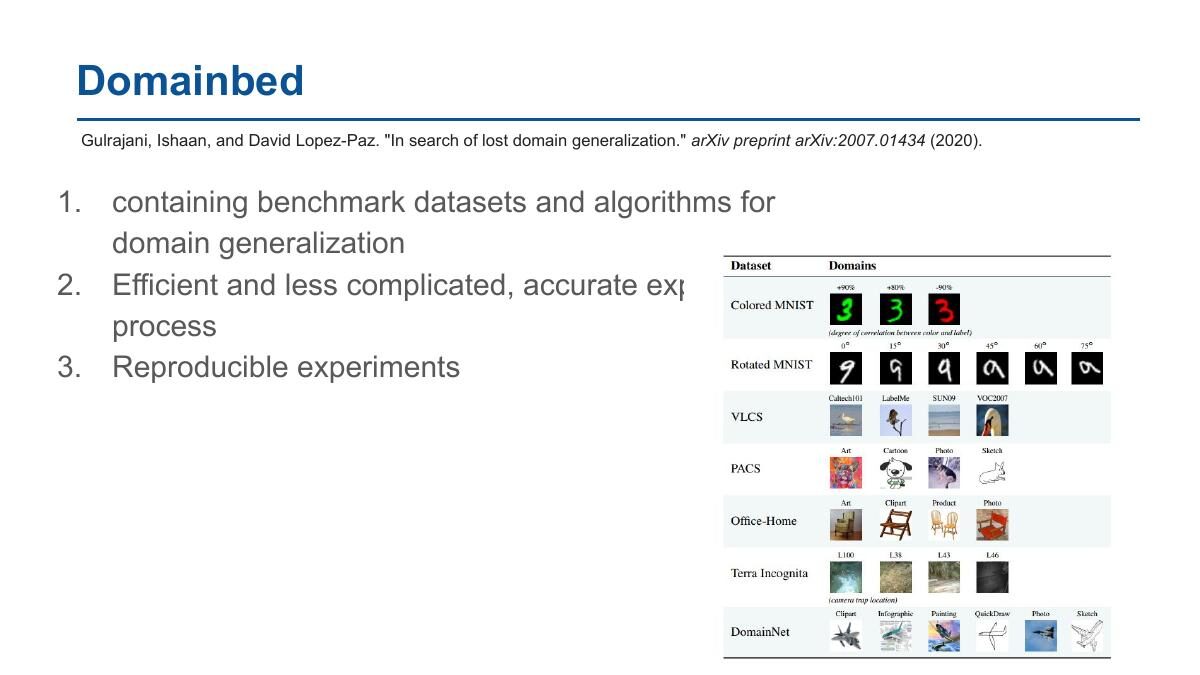
- các dataset và algorithm cho domain generalization;
- quy trình thực nghiệm tương đối gọn và nhất quán;
- hỗ trợ reproducible experiments.
Trang project được slide dẫn tới là github.com/facebookresearch/DomainBed.
Theo slide 19, phiên bản ban đầu có 9 algorithms, 7 datasets và 3 model selection methods. Con số này không chỉ để “khoe benchmark”; nó cho thấy một platform thống nhất có thể giúp cộng đồng giảm các khác biệt không cần thiết trong experimental setup.
Vì sao benchmark protocol quan trọng?
Giả sử hai phương pháp được báo cáo trên hai cách chia domain khác nhau. Một phương pháp dùng validation domain để chọn checkpoint, phương pháp còn lại dùng một protocol khác. Nếu chỉ nhìn vào accuracy cuối cùng, ta có thể đưa ra kết luận sai.
Một benchmark tốt nên giúp trả lời rõ:
- source domain và unseen target domain là gì;
- model selection diễn ra trên dữ liệu nào;
- algorithm có được tune theo từng dataset không;
- random seed, augmentation và backbone có được kiểm soát không;
- kết quả có tái lập được không.
Đặc biệt với DG, việc đánh giá không chỉ là chia train/test ngẫu nhiên. Ta cần kiểm tra đúng kiểu generalization mà mình tuyên bố.
Một vài bài học khi làm research về robustness
Từ domain adaptation sang domain generalization là một bước chuyển về cách đặt câu hỏi.
Trong adaptation, mình có thể hỏi: làm sao để thích nghi model với target domain mà mình biết?
Trong generalization, câu hỏi khó hơn: làm sao để model học được điều gì đó vẫn đúng khi target domain chưa từng xuất hiện?
Điều này khiến các bài toán như data diversity, shortcut learning, bias, model selection và reproducibility trở nên rất quan trọng. Robustness không chỉ là đạt accuracy cao hơn một chút; nó là việc hiểu model đang dựa vào tín hiệu nào và tín hiệu đó có còn tồn tại khi môi trường thay đổi không.
Kết
Domain shift là một trong những lý do khiến khoảng cách giữa benchmark và deployment lớn hơn ta tưởng. Domain adaptation giải quyết trường hợp target domain đã biết. Domain generalization cố gắng chuẩn bị cho một target domain chưa từng thấy.
Với mình, ý đáng nhớ nhất từ seminar là: một model tốt không chỉ cần làm đúng trên dữ liệu quen thuộc; nó cần biết cách không phụ thuộc quá mức vào những thứ không liên quan.
Và để biết phương pháp nào thật sự tốt, benchmark như DomainBed có vai trò rất quan trọng: cùng dataset, cùng protocol, thí nghiệm rõ ràng và kết quả có thể tái lập.