Semi-Supervised Medical Segmentation: Making Use of Unlabeled Data
Đây là bài ghi chú được mình rút trích và sắp xếp lại từ Seminar 1 - Delving into Semi-Supervised Medical Segmentation của AI VIETNAM. Mục tiêu là giải thích lại ý chính theo cách dễ đọc hơn, không thay thế cho nội dung đầy đủ trong slide.
📎 Mở toàn bộ slide seminar (PDF)
Bài toán bắt đầu từ một chuyện rất thực tế
Trong medical AI, dữ liệu thường không thiếu hoàn toàn. Vấn đề là dữ liệu được gán nhãn thì lại rất ít.
Hãy tưởng tượng một bệnh viện mỗi ngày thu thập hàng nghìn ảnh X-quang. Nhưng để biến một ảnh thành dữ liệu huấn luyện cho segmentation, cần có người đánh dấu vùng phổi hoặc vùng tổn thương trên từng ảnh. Công việc này vừa tốn thời gian, vừa đòi hỏi chuyên môn. Vì thế, trong thực tế ta thường có một tập nhỏ gồm ảnh và mask, bên cạnh một tập lớn chỉ có ảnh mà chưa có nhãn.
Slide 4-6 minh họa rất rõ khoảng cách này: supervised learning chỉ sử dụng được phần dữ liệu có mask, trong khi một lượng lớn dữ liệu không nhãn đang bị bỏ lại.
Vậy câu hỏi là: làm sao để mô hình học được gì đó từ phần dữ liệu chưa được gán nhãn?
Từ supervised learning đến pseudo-labeling
Trong supervised learning, mô hình dự đoán trên dữ liệu có nhãn rồi so sánh prediction với ground truth để tính loss. Ví dụ, với một ảnh, mô hình dự đoán xác suất của các lớp và ta dùng Cross-Entropy hoặc một loss phù hợp để cập nhật trọng số.
Nhưng với ảnh không nhãn, ta không có ground truth để so sánh.
Một ý tưởng tự nhiên là huấn luyện mô hình trên tập labeled trước. Sau đó dùng mô hình này dự đoán cho tập unlabeled, rồi coi prediction đó như một nhãn tạm thời. Cách làm này gọi là pseudo-labeling. Sơ đồ ở slide 7-8 mô tả đúng quy trình đó.
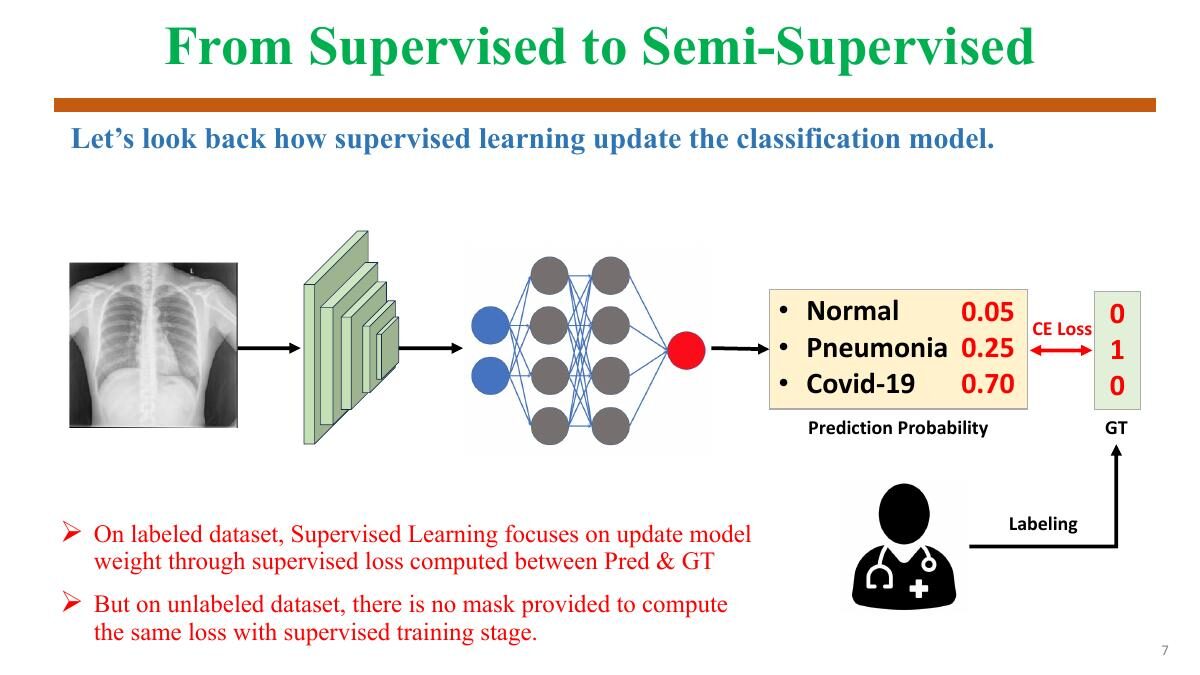
Pseudo-labeling khá hấp dẫn vì nó biến dữ liệu không nhãn thành dữ liệu “có nhãn”. Tuy nhiên, nhãn tạm thời này không phải sự thật tuyệt đối. Nếu mô hình ban đầu đoán sai, lỗi đó có thể được đưa ngược trở lại quá trình huấn luyện và làm mô hình tự củng cố sai lầm của mình.
Semi-supervised learning là gì?
Nói đơn giản, semi-supervised learning (SSL) là cách huấn luyện kết hợp cả dữ liệu labeled và unlabeled.
Theo slide 9-10, SSL nằm giữa nhiều chiến lược khác nhau khi dữ liệu có nhãn hạn chế:
- Pre-training rồi fine-tuning.
- Semi-supervised learning.
- Active learning.
- Pre-training kết hợp tự sinh dữ liệu.
SSL không chỉ có một công thức duy nhất. Nhiều phương pháp SSL khác nhau được xây dựng dựa trên những giả định khác nhau về dữ liệu.
Bốn giả định nền tảng của SSL
Slide 11 tổng hợp bốn hypotheses thường xuất hiện trong literature.
Smoothness assumption
Nếu hai điểm dữ liệu ở gần nhau trong một vùng có mật độ cao của feature space, chúng thường có cùng hoặc gần cùng nhãn.
Trực giác là: những mẫu rất giống nhau thì không nên bị mô hình tách thành hai lớp hoàn toàn khác nhau.
Cluster assumption
Dữ liệu thường tạo thành các cụm. Những điểm nằm trong cùng một cluster được kỳ vọng có cùng nhãn.
Giả định này mở rộng smoothness assumption từ quan hệ giữa hai điểm sang cấu trúc của cả nhóm dữ liệu.
Low-density separation assumption
Decision boundary nên đi qua vùng có mật độ thấp, thay vì cắt ngang một cluster dày đặc.
Nếu boundary cắt giữa một cụm các điểm rất giống nhau, khả năng cao mô hình đang phân chia dữ liệu theo cách không tự nhiên.
Manifold assumption
Dữ liệu quan sát có thể nằm trong không gian rất nhiều chiều, như toàn bộ pixel của một ảnh. Nhưng cấu trúc có ý nghĩa của dữ liệu thường nằm trên một manifold có số chiều thấp hơn.
Đây là một trực giác quan trọng cho representation learning: thay vì học từng pixel một cách rời rạc, mô hình cố gắng tìm một không gian biểu diễn trong đó sự giống nhau giữa các mẫu có ý nghĩa hơn.
Vấn đề của pseudo-label không chỉ là “đoán sai”
Để hiểu các phương pháp SSL sâu hơn, ta có thể nhìn vào feature representation.
Trong supervised learning, feature extractor và classifier được học chủ yếu từ dữ liệu labeled. Nếu tập labeled quá nhỏ, representation có thể bị lệch vì chưa nhìn thấy đủ độ đa dạng của từng class.
Slide 13-18 mô tả hai vấn đề liên quan:
- Feature extraction bị bias: feature space được xây dựng từ quá ít thông tin.
- Prototype không đại diện cho toàn bộ dữ liệu: một vài điểm labeled không thể mô tả hết hình dạng của class.
Hậu quả là các mẫu khó trong tập unlabeled dễ bị gán pseudo-label sai. Slide 19 dùng một ví dụ rất dễ hình dung: mô hình nhìn một ảnh khó phân biệt giữa hai class rồi buộc phải nói “đây là dog” hoặc “đây là cat”, dù confidence không thật sự thuyết phục.
Khi những nhãn nhiễu này được dùng lại để train, mô hình có thể học thêm bias thay vì học thêm thông tin mới.
Từ classification đến semantic segmentation
Trong classification, mỗi ảnh thường có một nhãn. Trong semantic segmentation, mỗi pixel cần được gán nhãn. Vì vậy, chi phí annotation còn lớn hơn đáng kể.
Mỗi mask y tế có thể yêu cầu chuyên gia đánh dấu rất chi tiết. Điều này khiến semi-supervised semantic segmentation trở thành một hướng nghiên cứu quan trọng: ta muốn tận dụng ảnh chưa có mask mà vẫn giữ được chất lượng pixel-level prediction.
Slide 24 tóm tắt động lực của bài toán này: semantic segmentation vốn đã khó, còn pixel-level labeling thì đắt và tốn thời gian.
Một số nhánh phương pháp chính
Consistency regularization
Ý tưởng cốt lõi là: nếu ta tạo ra các phiên bản thay đổi nhẹ của cùng một ảnh, prediction của mô hình nên nhất quán.
Trong classification, FixMatch là một ví dụ nổi tiếng. Mô hình có thể dùng một augmentation yếu để tạo pseudo-label, sau đó yêu cầu prediction trên augmentation mạnh vẫn khớp với nhãn đó. Slide 22-23 nhắc đến FixMatch và các hướng phát triển như Dash, FlexMatch, FreeMatch.
Trực giác của consistency regularization khá tự nhiên: thay đổi nhỏ về ánh sáng, crop hoặc nhiễu không nên khiến mô hình đổi hoàn toàn nhận định về nội dung ảnh.
Feature perturbation
Thay vì chỉ thay đổi input, ta có thể perturb feature representation trong quá trình học. CCT là một ví dụ được nhắc ở slide 25.
Co-training và nhiều nhánh dự đoán
Một hướng khác là để các nhánh hoặc các view khác nhau hỗ trợ lẫn nhau. Mỗi nhánh có thể đưa ra thông tin bổ sung, sau đó cùng regularize prediction của mô hình.
Slide 26 đặt co-training cạnh các hướng phát triển từ FixMatch. Đối với medical segmentation, việc xây dựng nhiều nhánh có thể giúp mô hình nhìn dữ liệu dưới các biến đổi hoặc representation khác nhau.
Slide 27 gợi ra bức tranh rộng hơn của các nhánh semi-supervised medical segmentation. Điểm chung là chúng đều cố gắng biến dữ liệu chưa có mask thành tín hiệu học hữu ích, nhưng mỗi nhánh có cách kiểm soát noise và bias khác nhau.
Điều quan trọng nhất khi đọc một phương pháp SSL
Khi đọc một paper semi-supervised, mình nghĩ nên hỏi ít nhất bốn câu:
- Phần nào của dữ liệu được labeled, phần nào là unlabeled?
- Pseudo-label được tạo ra như thế nào?
- Mô hình kiểm soát pseudo-label nhiễu ra sao?
- Nếu thay đổi tỷ lệ labeled/unlabeled hoặc domain dữ liệu, phương pháp còn hoạt động tốt không?
Chỉ nhìn vào điểm số cuối cùng là chưa đủ. Với SSL, chất lượng và tỷ lệ của labeled data, cách augmentation, confidence threshold, consistency loss và protocol đánh giá đều có thể ảnh hưởng rất lớn đến kết quả.
Kết
Semi-supervised medical segmentation bắt đầu từ một hạn chế rất đời thường: dữ liệu thì nhiều, nhưng mask tốt thì ít.
Từ đó, research đi qua nhiều lớp ý tưởng: pseudo-labeling, các giả định về feature space, consistency regularization, feature perturbation, co-training và nhiều nhánh dự đoán. Không có phương pháp nào tự động giải quyết mọi vấn đề. Nếu pseudo-label sai, unlabeled data có thể trở thành nguồn noise; nếu representation bị bias, mô hình có thể tự tin vào một cách nhìn chưa đầy đủ.
Vì vậy, điều mình thấy đáng nhớ nhất không phải là một tên method cụ thể, mà là cách đặt câu hỏi: mình đang dùng dữ liệu không nhãn để bổ sung thông tin, hay chỉ đang lặp lại những bias đã có trong mô hình?