Understanding Volumetric Medical Images: 3D CNNs, 3D U-Net, and 2.5D Models
Đây là bài ghi chú được mình rút trích từ Seminar 3 - Exploring Disease Classification Methods for Volumetric (3D) Medical Image (CTs/MRIs) của AI VIETNAM. Mình tập trung vào trực giác và pipeline chính trong slide, còn các chi tiết implementation nên xem lại trong PDF gốc.
📎 Mở toàn bộ slide seminar (PDF)
Ảnh y khoa không phải lúc nào cũng chỉ là một ảnh
Khi nhìn một ảnh 2D, ta thường nghĩ input là một ma trận chiều cao × chiều rộng. Nhưng CT hoặc MRI thường được tạo thành từ một series of images: nhiều lát cắt xếp chồng theo chiều sâu.
Tập hợp các lát cắt này tạo thành một volumetric image. Thay vì chỉ nhìn một mặt phẳng, ta có thể quan sát cấu trúc theo cả ba chiều.
Slide 3-4 đưa ra các ví dụ từ video, BraTS brain tumor segmentation và RSNA abdominal trauma detection. Cùng một ý tưởng “nhiều frame/lát cắt tạo thành một volume” xuất hiện trong nhiều bài toán khác nhau.
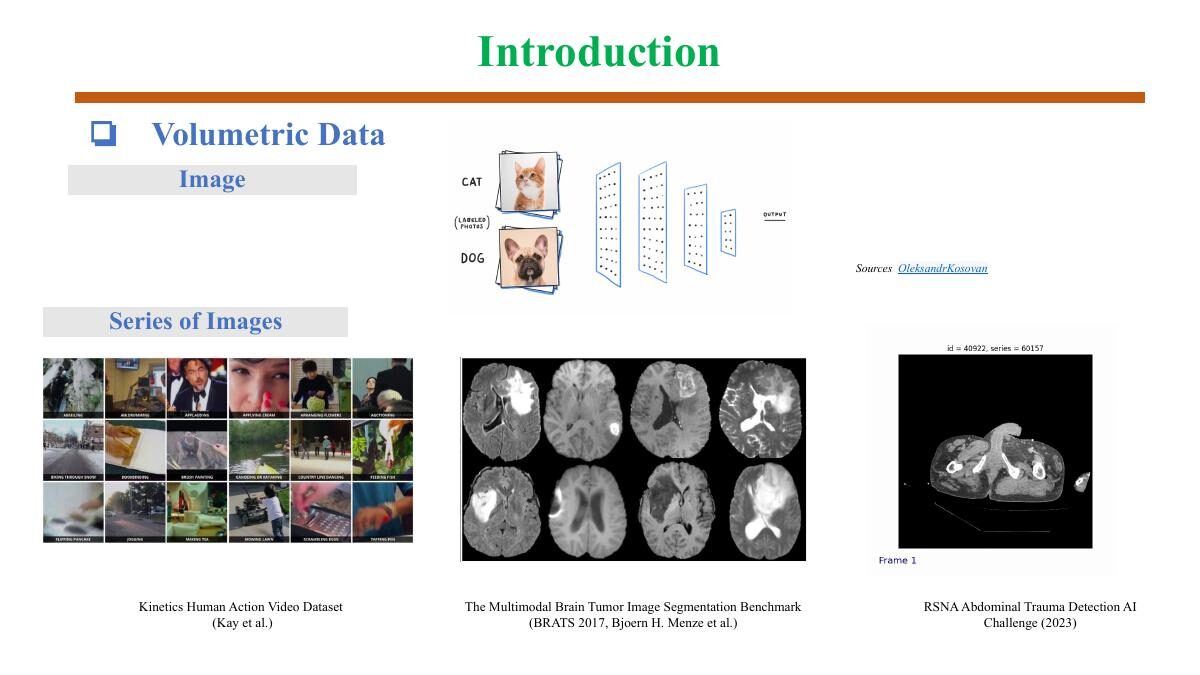
Điểm này quan trọng vì một tổn thương y khoa có thể không thể hiện đầy đủ trong một lát cắt đơn lẻ. Thông tin ở các lát cắt bên cạnh có thể giúp mô hình hiểu hình dạng và sự liên tục của cấu trúc.
Từ 2D CNN sang 3D CNN
2D CNN áp dụng kernel trên hai chiều không gian. Khi chuyển sang 3D CNN, kernel có thêm một chiều depth để quét qua nhiều lát cắt liên tiếp.
Slide 6 minh họa một tensor đầu vào có dạng:
[batch size, depth, channels, width, height]
Ví dụ trong slide, input có kích thước [1, 16, 3, 32, 32]. Một kernel 3 × 3 × 3 có thể nhìn đồng thời theo depth, width và height. Sau convolution, output vẫn giữ cấu trúc volumetric nhưng có thể thay đổi số channel, kích thước không gian và độ sâu.
Trực giác của 3D CNN là mô hình không chỉ học pattern trong một lát cắt, mà còn học cách pattern đó thay đổi qua các lát cắt kế bên.
Đổi lại, 3D CNN thường tốn compute và memory hơn 2D CNN. Đây là trade-off quan trọng trong medical imaging: thêm context 3D có thể giúp prediction, nhưng cũng làm training và inference nặng hơn.
Từ 2D U-Net sang 3D U-Net
U-Net là một kiến trúc quen thuộc cho segmentation, với encoder để trích xuất feature và decoder để khôi phục độ phân giải. Skip connection nối feature ở encoder với decoder để giữ lại thông tin không gian chi tiết.
Khi chuyển sang 3D U-Net, các operation 2D được thay bằng operation 3D để xử lý volume. Slide 7-11 đi từ review 2D U-Net đến các bước hình thành 3D U-Net.
Điểm mạnh của 3D U-Net là có thể dự đoán mask với context theo cả ba chiều. Nhưng nó cũng phải trả giá bằng tensor lớn hơn, memory usage cao hơn và preprocessing phức tạp hơn.
RSNA 2023: một bài toán volumetric thực tế
Phần tiếp theo của seminar lấy RSNA 2023 làm ví dụ. Slide 12-16 giới thiệu dữ liệu theo study và nhiều cơ quan trong cùng một volume.
Pipeline được trình bày theo hai stage:
- 3D segmentation: xác định hoặc tách các vùng cơ quan trong volume.
- 2.5D CNN + RNN: dùng các lát cắt liên tiếp để dự đoán bệnh hoặc injury.
Đây là một thiết kế khá thú vị. Stage 1 giúp tạo segmentation hoặc vùng quan tâm. Stage 2 sử dụng thông tin theo chuỗi để làm classification.
Preprocessing: windowing và rescaling
Medical images không thể lúc nào cũng đưa thẳng vào model như ảnh RGB thông thường.
Windowing
CT có giá trị intensity trải rộng. Windowing chọn một khoảng giá trị phù hợp để làm nổi bật mô hoặc cấu trúc cần quan sát.
Slide 17 nhắc đến windowing trong preprocessing của RSNA.
Rescaling
Các study có thể có kích thước volume và spacing khác nhau. Rescaling giúp đưa dữ liệu về một scale phù hợp hơn cho model.
Slide 18 minh họa sự khác biệt giữa kích thước volume và volume segment. Trong thực tế, resampling cần được thực hiện cẩn thận vì interpolation có thể ảnh hưởng đến hình dạng và thông tin của tổn thương.
Vì sao lại cần 2.5D?
3D model có context đầy đủ nhưng nặng. 2D model nhẹ hơn nhưng có thể thiếu thông tin giữa các lát cắt. 2.5D là một cách đứng ở giữa: dùng nhiều lát cắt 2D liên tiếp làm input, nhưng vẫn tận dụng backbone 2D.
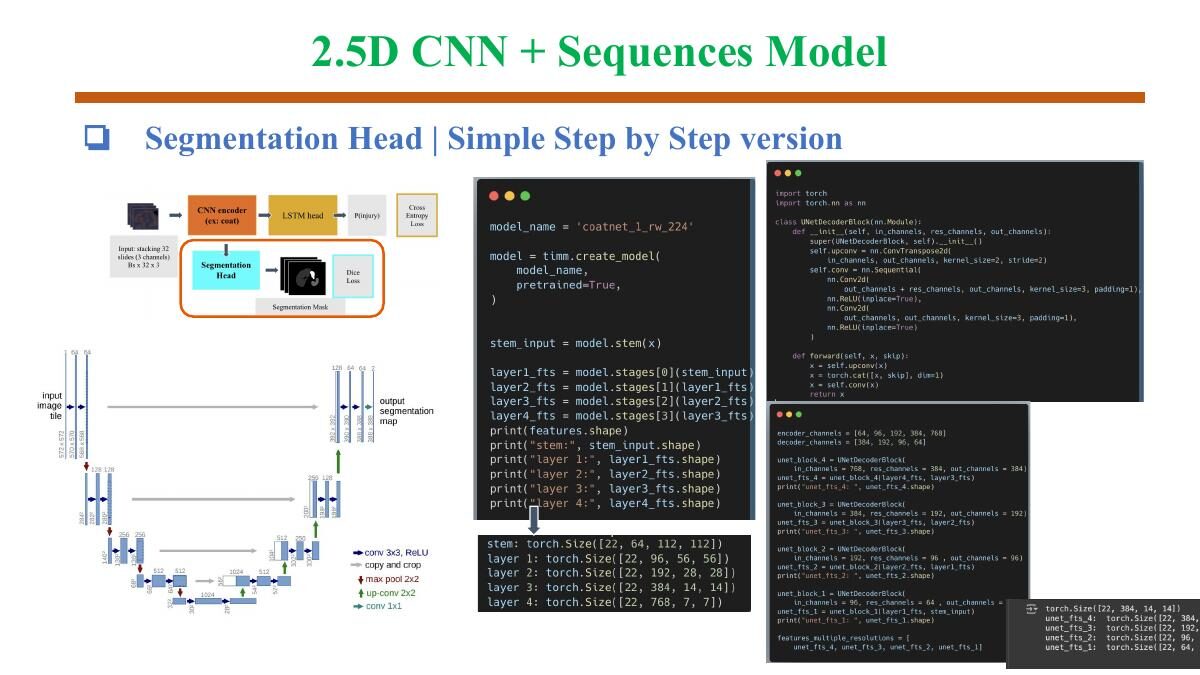
Trong slide, một input được tạo bằng cách stack 32 slices với 3 channels. CNN encoder trích xuất feature, sau đó một LSTM head xử lý chuỗi feature để dự đoán xác suất injury. Đồng thời, segmentation head tạo mask phụ với Dice loss.
Slide 20 minh họa pipeline chính:
Stacked slices
      ↓
  CNN encoder ─────→ LSTM head ─────→ P(injury)
      │                  │
      └────────────→ Segmentation head
Loss có thể kết hợp classification loss và segmentation loss. Segmentation đóng vai trò auxiliary task, giúp feature extractor học được thông tin không gian hữu ích hơn.
Một điểm đáng chú ý trong slide là backbone và sequence model có thể thay thế. CNN encoder có thể đổi sang ViT, Swin hoặc CoaT; RNN có thể mở rộng bằng attention hoặc Transformer head.
LSTM và segmentation head
Slide 21-25 tách pipeline 2.5D thành các thành phần nhỏ hơn:
- CNN encoder để lấy feature từ từng input slice hoặc nhóm slice;
- LSTM head để tổng hợp thông tin theo sequence;
- segmentation head để tạo mask;
- FPN để kết hợp feature ở nhiều scale.
Cách trình bày theo từng bước này khá hữu ích khi implement. Thay vì nhìn một sơ đồ lớn và không biết bắt đầu từ đâu, mình có thể kiểm tra từng block: feature shape sau encoder là gì, sequence length nằm ở đâu, LSTM nhận tensor theo format nào, và segmentation head khôi phục spatial resolution ra sao.
Upsampling: ConvTranspose, Interpolation hay Pixel Shuffle?
Decoder và segmentation head thường cần đưa feature map về độ phân giải cao hơn. Slide 26-28 giới thiệu ba lựa chọn:
- ConvTranspose2d: học kernel để upsample, nhưng có thể tạo checkerboard artifacts nếu cấu hình không phù hợp;
- Interpolation: đơn giản và ít tham số hơn, nhưng không tự học được cách khôi phục feature;
- Pixel Shuffle: sắp xếp lại channel thành không gian, thường được dùng trong super-resolution và các bài toán upsampling.
Không có lựa chọn nào luôn tốt nhất. Cần nhìn vào output, memory, tốc độ và loại artifact có thể xuất hiện. Slide cũng dẫn tới một notebook visualization để so sánh trực quan giữa pixel shuffle, transposed convolution và interpolation.
Điều mình thấy thú vị ở thiết kế multi-task
Pipeline 2.5D trong seminar không chỉ dùng classification. Nó còn có segmentation head như một auxiliary task.
Điều này gợi ra một chiến lược phổ biến trong deep learning: nếu một task phụ buộc model phải học representation có cấu trúc hơn, task chính có thể được hưởng lợi. Trong trường hợp này, segmentation giúp model chú ý đến vùng cơ thể hoặc vùng tổn thương thay vì chỉ học một tín hiệu global khó giải thích.
Tuy nhiên, multi-task learning cũng cần cân bằng loss. Nếu segmentation loss quá lớn, model có thể tối ưu mask tốt nhưng classification chưa chắc tốt. Nếu classification loss lấn át, segmentation head có thể trở thành một nhánh phụ hình thức.
Một checklist khi bắt đầu với volumetric data
Nếu tự triển khai một bài toán tương tự, mình sẽ kiểm tra:
- Volume có bao nhiêu chiều và thứ tự các chiều trong tensor là gì?
- Spacing giữa các slice có đồng nhất không?
- Windowing và normalization đang giữ lại thông tin nào?
- Có cần toàn bộ volume hay có thể dùng patch/sequence?
- 3D CNN có vừa memory không, hay 2.5D là lựa chọn hợp lý hơn?
- Nếu dùng RNN/LSTM, sequence length và thứ tự slice có được xử lý đúng không?
- Upsampling có tạo artifact không?
- Metric segmentation và classification có phản ánh đúng mục tiêu y khoa không?
Kết
Volumetric medical imaging đưa thêm một chiều rất quan trọng vào bài toán computer vision. 3D CNN và 3D U-Net cho phép model nhìn context theo depth, nhưng đòi hỏi nhiều compute hơn. 2.5D CNN + RNN là một hướng cân bằng: tận dụng backbone 2D, bổ sung thông tin từ các slice liên tiếp và có thể kết hợp thêm segmentation head.
Điều mình rút ra từ seminar là: trước khi chọn model, cần hiểu dữ liệu đang có cấu trúc gì. Nếu input thực sự là một volume, việc ép nó thành một ảnh 2D có thể làm mất thông tin. Nhưng nếu dùng 3D model quá nặng, pipeline cũng khó chạy trong thực tế. Lựa chọn tốt thường nằm ở việc cân bằng context, chi phí và mục tiêu cần dự đoán.