From Autonomous Driving to Domain Adaptation: Research Lessons from AI Projects
Đây là bài ghi chú được mình rút trích từ seminar Alumni: Do Tran Nhat Tuong của AI VIETNAM. Bài nói đi qua khá nhiều project, từ xe tự hành và hệ thống retrieval đến các hướng nghiên cứu như domain adaptation, point cloud augmentation và style transfer.
📎 Mở toàn bộ slide seminar (PDF)
Một lộ trình đi từ ứng dụng đến research
Điểm thú vị của seminar là diễn giả không bắt đầu bằng một danh sách thuật toán, mà bắt đầu bằng hành trình học tập và các bài toán đã từng làm. Từ Automotive Engineering, các cuộc thi về xe tự hành và khóa học AI, hướng đi dần mở sang Computer Science, computer vision và research.
Slide 2 phác họa các topic chính gồm domain adaptation, lane segmentation, object detection, scene recognition, embedded system, style transfer và data augmentation. Một project thực tế thường chạm vào nhiều lớp kiến thức cùng lúc: perception, dữ liệu, mô hình và khả năng chạy trên phần cứng giới hạn.
Xe tự hành: từ simulation đến real-world
Lane segmentation
Trong simulation, pipeline được chia thành các thành phần quen thuộc của autonomous driving: camera image đi qua lane detection và object detection, sau đó kết quả được đưa vào hệ thống mô phỏng.
Slide 7 so sánh ba mô hình cho lane segmentation. U-Net đạt IoU 94.8%, nhưng tốc độ thấp hơn ở mức 49.63 FPS trên RTX 3090. BiSeNet đạt IoU 92.1% và 105.80 FPS, còn ENet đạt IoU 90.2% và 98.26 FPS.
Đây là một ví dụ rõ cho trade-off giữa độ chính xác và tốc độ. Khi làm research, mình có thể quan tâm đến điểm số tốt nhất. Nhưng khi đưa mô hình vào xe hoặc robot, FPS, memory và độ trễ cũng quan trọng không kém.
Object detection
Slide 9 trình bày kết quả của YOLOv5m, YOLOv6n và YOLOv7. Các mô hình đều cho precision và recall cao trong thí nghiệm, nhưng YOLOv6n có tốc độ 307.69 FPS, trong khi YOLOv7 đạt mAP@0.5:0.95 cao nhất trong bảng với 0.884.
Không có một model duy nhất tốt nhất cho mọi tiêu chí. Việc chọn model cần dựa vào mục tiêu của hệ thống: ưu tiên latency, accuracy, kích thước model hay khả năng triển khai.
Chạy trên xe thật
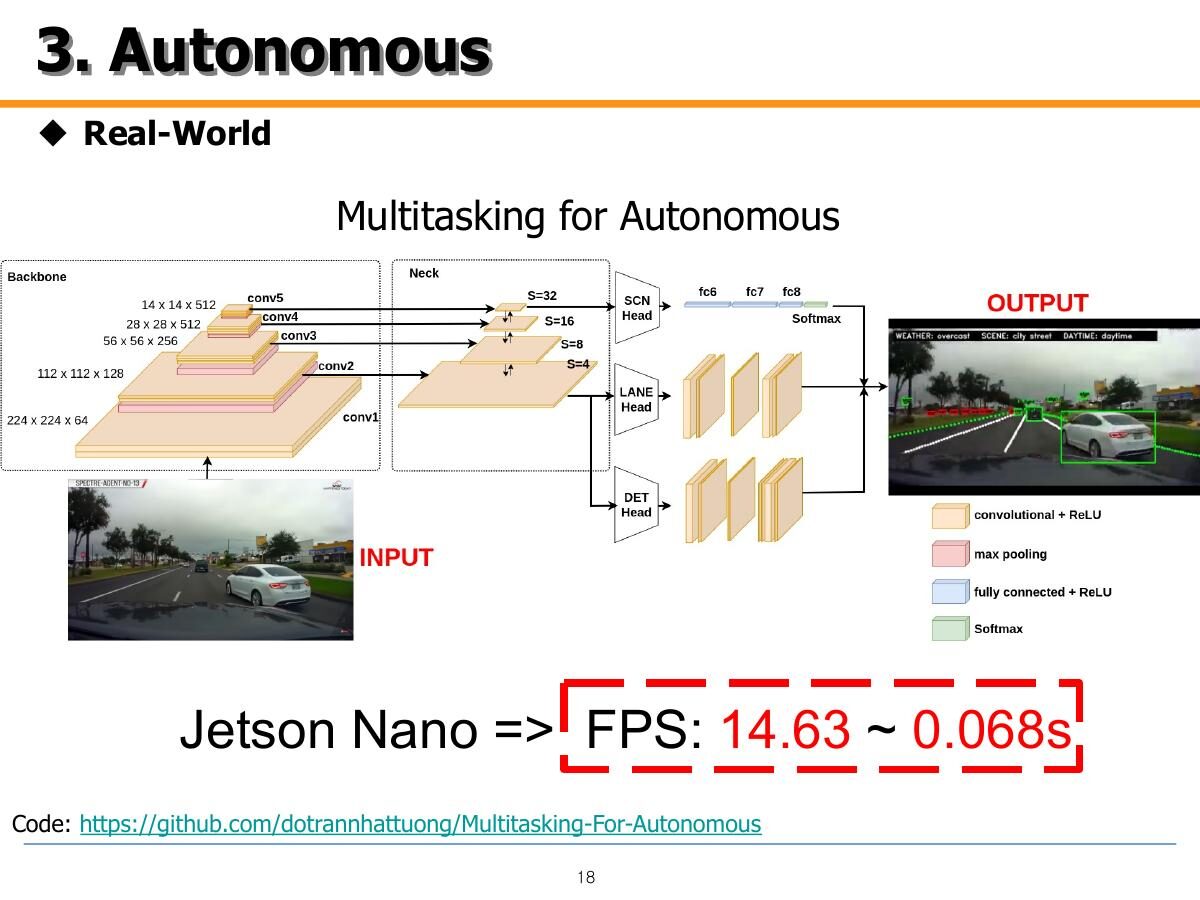
Khi chuyển từ simulation sang real-world, bài toán trở nên phức tạp hơn vì sensor, ánh sáng, rung động, góc nhìn và giới hạn compute đều thay đổi. Slide giới thiệu một hệ thống multitasking cho autonomous driving, trong đó một model cùng xử lý lane segmentation và object detection.
Project được chạy trên Jetson Nano với tốc độ khoảng 14.63 FPS, tương đương khoảng 0.068 giây mỗi frame. Kết quả trên slide 19 cho thấy mô hình multitask đạt IoU 95.0% cho segmentation và mAP 88.1% cho detection.
🔗 Code: Multitasking for Autonomous
Multitask model không chỉ nhằm gộp hai bài toán cho gọn. Nếu thiết kế tốt, các task có thể hỗ trợ representation của nhau, đồng thời giảm chi phí so với việc chạy hai model độc lập.
Từ bài toán ứng dụng đến các hệ thống khác
Smart Menu OCR
Smart Menu là một hệ thống nhận dạng thông tin trên menu. Phần problem definition và architecture nằm ở slide 23-24. Một bài toán OCR thường không chỉ là nhận dạng ký tự. Hệ thống còn phải xử lý layout, chất lượng ảnh, ngôn ngữ và cách chuyển kết quả nhận dạng thành dữ liệu có ích.
Video-text retrieval
Trong video-text retrieval, người dùng mô tả một nội dung bằng ngôn ngữ tự nhiên và hệ thống cần tìm những đoạn video phù hợp. Slide 25-26 đưa ra các ví dụ truy vấn và kiến trúc của hệ thống.
Điểm khó nằm ở việc nối hai modality khác nhau: video chứa hình ảnh và chuyển động, còn truy vấn chứa thông tin ngôn ngữ. Representation và cách huấn luyện alignment giữa video với text đóng vai trò quan trọng.
🔗 Code: Video-Text Retrieval · Paper
Domain adaptation: khi train và test khác domain
Một hướng research chính trong seminar là domain adaptation. Model được train trên source domain và cần thích nghi sang target domain. Sự khác biệt giữa hai domain có thể đến từ camera, môi trường, dữ liệu, style hoặc cách thu thập.
Project Learning CNN on ViT: A Hybrid Model to Explicitly Class-specific Boundaries for Domain Adaptation được giới thiệu như một công trình tại CVPR 2024. Kiến trúc kết hợp một nhánh ViT và một nhánh CNN, mỗi nhánh có encoder và classifier riêng. Slide 28-31 minh họa kiến trúc cùng các visualization như t-SNE và attention map.
🔗 Project page · Paper
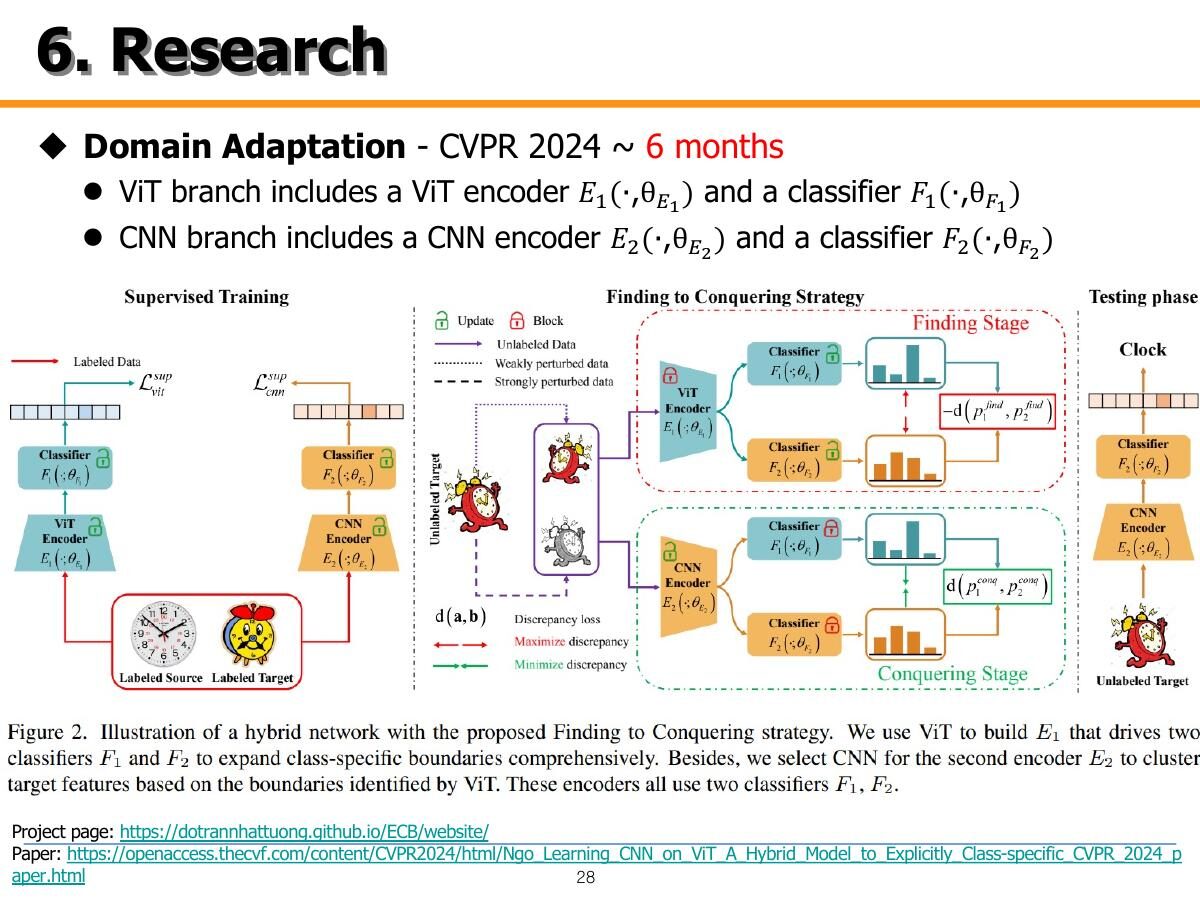
Trực giác của hướng này là không nên chỉ dựa vào một kiểu feature. CNN có inductive bias tốt cho local pattern, còn ViT có khả năng nắm bắt quan hệ xa hơn trong ảnh. Kết hợp hai nhánh có thể giúp model học representation phù hợp hơn khi domain thay đổi.
Data augmentation và style transfer
Slide 32-34 trình bày một hướng data augmentation trên point cloud. Pipeline dùng teacher, student và augmenter, sau đó tích lũy các block augmentation theo thời gian. Dynamic threshold được dùng để quyết định cách chọn hoặc thay thế augmentation.
Augmentation không chỉ là tạo ra thật nhiều biến thể ngẫu nhiên. Ta cần kiểm soát mức độ thay đổi để dữ liệu mới vẫn giữ semantic của dữ liệu gốc và thực sự giúp model robust hơn.
Phần style transfer ở slide 35-36 cho thấy một cách khác để thay đổi appearance của dữ liệu. Nếu domain shift nằm ở style hoặc điều kiện quan sát, style transfer có thể được dùng để tạo thêm variation trong quá trình huấn luyện.
Mình rút ra điều gì?
Khoảng cách giữa một demo và một hệ thống chạy được ngoài đời khá lớn. Một project tốt cần trả lời đồng thời nhiều câu hỏi:
- Model có đủ chính xác cho task không?
- Tốc độ và memory có phù hợp với phần cứng không?
- Khi dữ liệu đổi domain, model có còn ổn định không?
- Có thể kiểm tra kết quả bằng visualization hay không?
- Code, dữ liệu và protocol có đủ rõ để người khác tái lập không?
Từ autonomous driving đến domain adaptation, các project khác nhau nhưng đều quay về một bài toán chung: làm sao để model học được tín hiệu có ích và vẫn hoạt động khi môi trường thật không giống dữ liệu training.